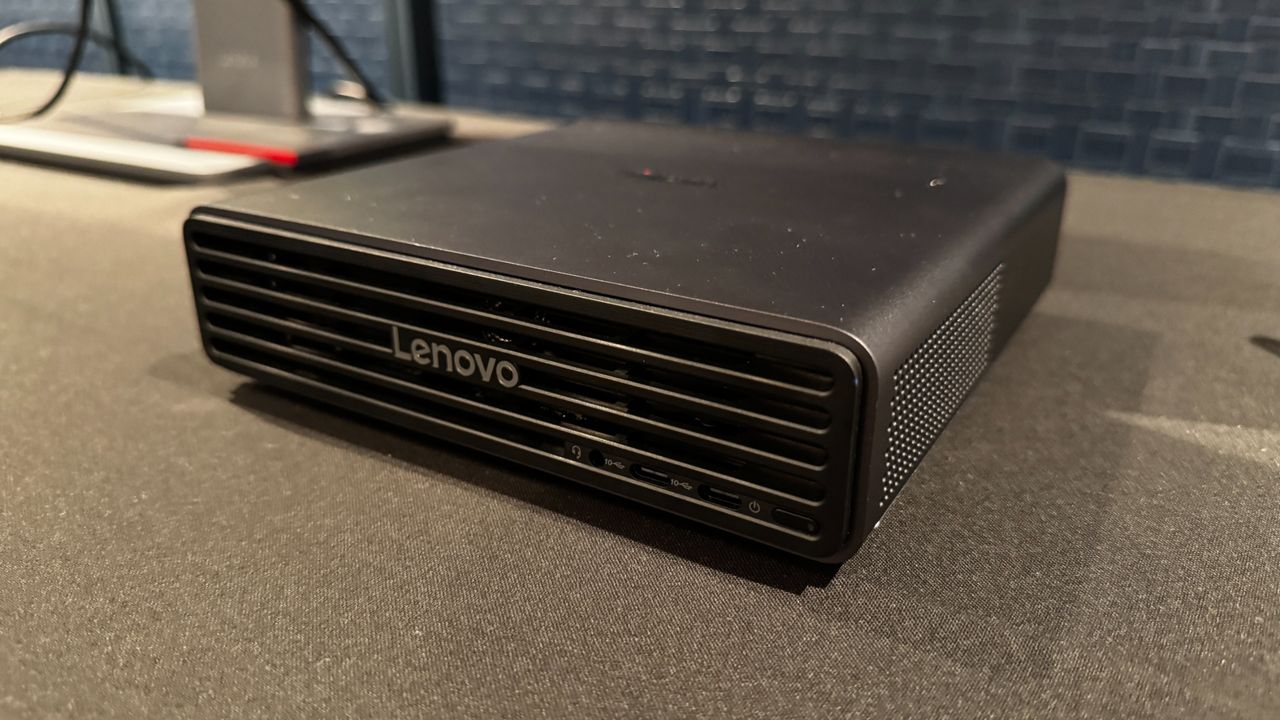
Microsoft a présenté Project Zenith lors de la révélation matérielle d'Acemagic, marquant une offensive conjointe matérielle et logicielle pour le développement d'IA locale. Project Zenith est une version spécialisée de Windows 11 conçue spécifiquement pour les développeurs d'IA, livrée préconfigurée avec des environnements de programmation essentiels. Parallèlement, Acemagic a présenté le mini-PC Gorgon Halo à l'IFA 2026, une station de travail compacte conçue pour supporter de lourdes charges de calcul sur l'appareil.
Infrastructure logicielle optimisée
Project Zenith simplifie le processus de configuration pour les ingénieurs en apprentissage automatique en intégrant les utilitaires de développement directement dans le système d'exploitation. La plateforme est livrée avec des outils préinstallés, notamment Visual Studio Code et GitHub Copilot, ce qui élimine les obstacles liés à la configuration manuelle. Cependant, l'architecture du système exige des ressources substantielles pour fonctionner. Microsoft spécifie une exigence minimale de 64 Go de mémoire unifiée, positionnant clairement le système d'exploitation dans la catégorie des stations de travail haut de gamme.
Matériel compact haut de gamme
Pour prendre en charge des environnements gourmands en ressources tels que Project Zenith, Acemagic a conçu le mini-PC Gorgon Halo autour de l'architecture Strix Halo d'AMD. Mesurant 158,5 x 158,5 x 81,5 mm, le châssis abrite un APU AMD Ryzen AI Max+ PRO 495. Ce processeur utilise une configuration de processeur Zen 5 à 16 cœurs associée à une prise en charge de mémoire haute capacité. La machine peut accueillir jusqu'à 192 Go de RAM LPDDR5X, répondant aux prérequis de mémoire de Microsoft pour l'exécution de modèles locaux.
L'architecture matérielle intégrée offre un rendement de traitement combiné de 131 TOPS répartis entre ses composants CPU, GPU et NPU. Ce niveau de débit permet aux ingénieurs de contourner l'infrastructure cloud externe pour les opérations sur des modèles de taille moyenne.
L'exécution locale de modèles d'apprentissage automatique sur ces systèmes permet aux développeurs d'exécuter des routines d'inférence et de réglage fin sur des paramètres dépassant 30 milliards sans encourir de frais de facturation cloud par jeton. Malgré les économies opérationnelles à long terme sur les appels d'API, les dépenses d'investissement immédiates restent élevées. L'exigence de 64 Go à 192 Go de mémoire haute vitesse et d'APU spécialisés constitue un obstacle financier important à l'entrée pour les développeurs indépendants et les studios plus modestes adoptant des flux de travail d'IA locale.
Au-delà des implications financières immédiates, la transition vers un développement d'IA axé sur le local reflète une tendance plus large de l'industrie qui priorise la souveraineté et la confidentialité des données. En conservant les ensembles de données sensibles et les modèles propriétaires sur l'appareil, les organisations peuvent atténuer les risques associés à la transmission de la propriété intellectuelle à des fournisseurs cloud tiers. Cette approche d'apprentissage automatique isolée est de plus en plus cruciale pour les secteurs traitant des informations sensibles médicales, financières ou liées à la défense, où les exigences de résidence des données empêchent souvent l'utilisation d'API LLM publiques.