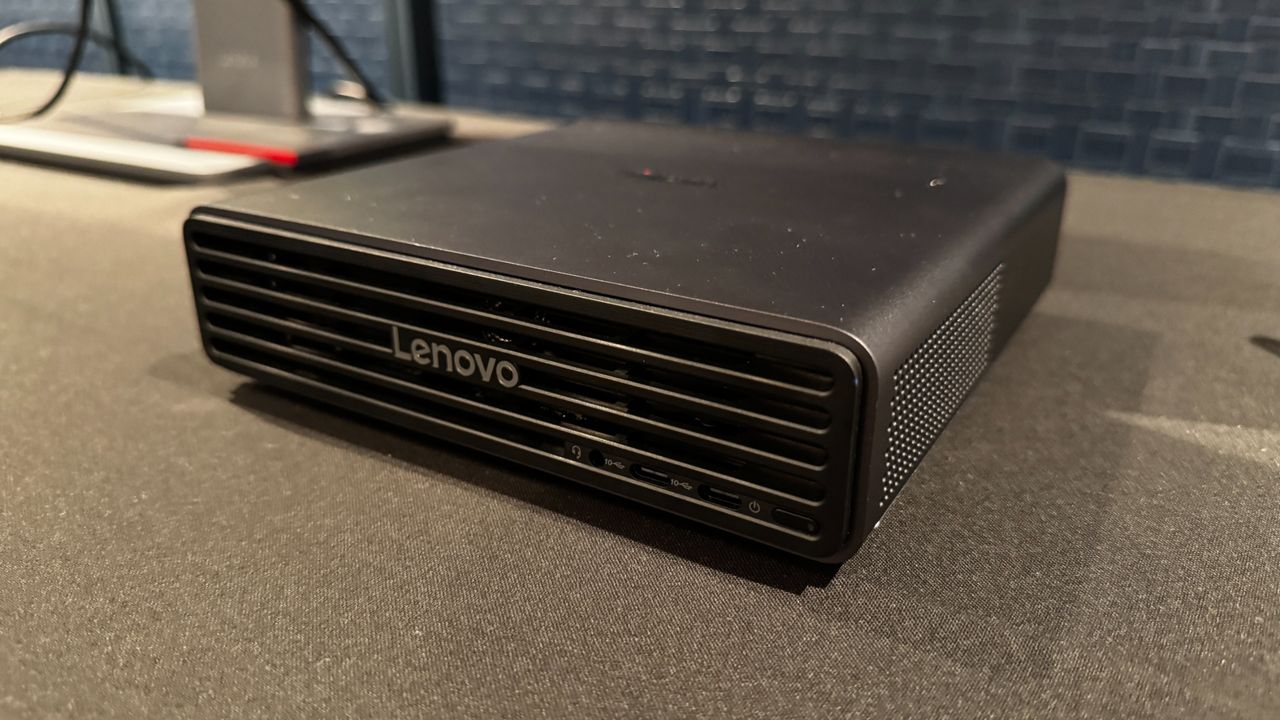
Microsoft ha presentado Project Zenith junto con la revelación de hardware de Acemagic, marcando un impulso de hardware y software para el desarrollo de IA local. Project Zenith es una compilación especializada de Windows 11 adaptada específicamente para desarrolladores de IA, que viene preconfigurada con entornos de programación esenciales. Simultáneamente, Acemagic exhibió el mini-PC Gorgon Halo en la feria IFA 2026, una estación de trabajo compacta diseñada para soportar cargas de trabajo computacionales pesadas en el dispositivo.
Infraestructura de software optimizada
Project Zenith simplifica el proceso de configuración para los ingenieros de aprendizaje automático al integrar utilidades de desarrollo directamente en el sistema operativo. La plataforma se entrega con herramientas preinstaladas que incluyen Visual Studio Code y GitHub Copilot, eliminando los obstáculos de la configuración manual. Sin embargo, la arquitectura del sistema exige recursos sustanciales para funcionar. Microsoft especifica un requisito mínimo de 64 GB de memoria unificada, situando al sistema operativo de lleno en la categoría de estaciones de trabajo de alta gama.
Hardware compacto de alta gama
Para admitir entornos con uso intensivo de recursos como Project Zenith, Acemagic diseñó el mini-PC Gorgon Halo basándose en la arquitectura Strix Halo de AMD. Con unas medidas de 158,5 x 158,5 x 81,5 mm, el chasis alberga una APU AMD Ryzen AI Max+ PRO 495. Este procesador utiliza una configuración de CPU Zen 5 de 16 núcleos combinada con compatibilidad de memoria de alta capacidad. La máquina admite hasta 192 GB de memoria RAM LPDDR5X, cumpliendo con los requisitos previos de memoria de Microsoft para la ejecución de modelos locales.
La arquitectura de hardware integrada ofrece un rendimiento de procesamiento combinado de 131 TOPS en sus componentes de CPU, GPU y NPU. Este nivel de rendimiento permite a los ingenieros omitir la infraestructura de nube externa para operaciones de modelos a mediana escala.
Ejecutar modelos de aprendizaje automático localmente en estos sistemas permite a los desarrolladores realizar rutinas de inferencia y ajuste fino en parámetros que superan los 30 mil millones sin incurrir en tarifas de facturación en la nube basadas en tokens. A pesar del ahorro operativo a largo plazo en llamadas a la API, el gasto de capital inmediato sigue siendo elevado. El requisito de 64 GB a 192 GB de memoria de alta velocidad y APUs especializadas establece una barrera de entrada costosa para desarrolladores independientes y estudios más pequeños que adoptan flujos de trabajo de IA local.